两个细微的模型能力变化,如何带动了整个 AI 能力的升级
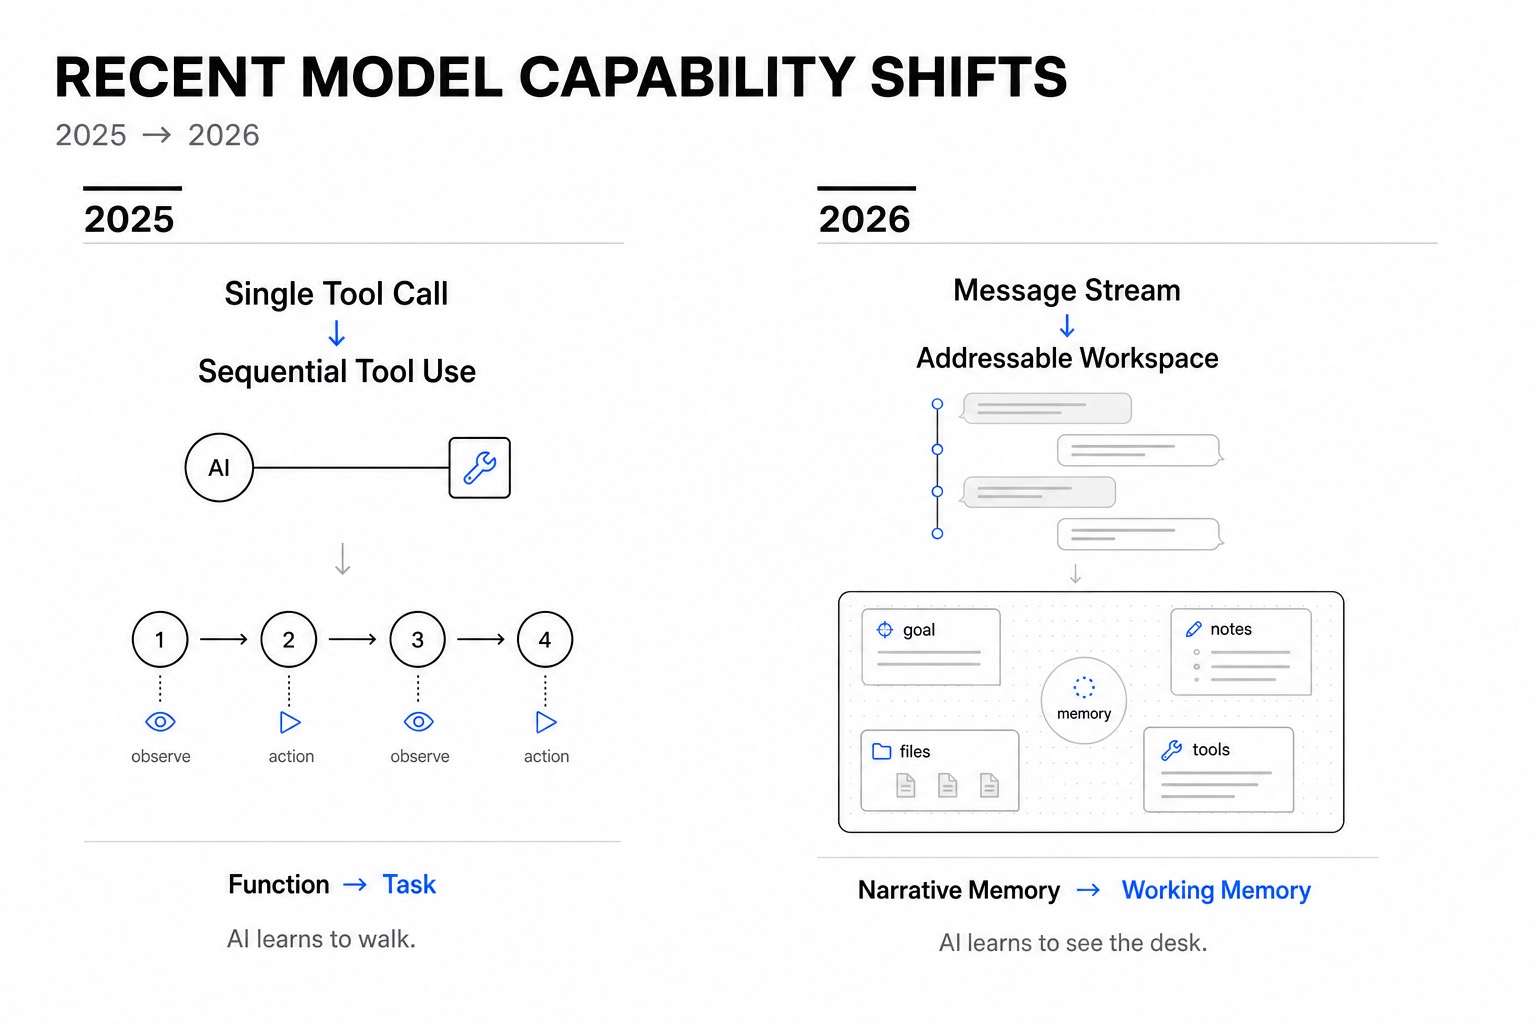
过去两年,如果你一直在用大语言模型做产品,你一定被各种概念轰炸过:Agent、Harness、Context Engineering、Prompt Caching、Tool Orchestration……词汇表每个季度都在膨胀。
但拨开这些噪音,真正发生变化的只有两件事。两个安静的、来自模型训练层面的能力跃迁。我们看到的所有框架、架构、产品品类,都是这两个变化的下游产物。
第一个变化:从单次工具调用到连续工具使用(2025)
2024 年初,工具调用长这样:
一个请求,一次调用,一个回答。模型是一个路由器——判断该调哪个函数,调完把结果格式化返回。
到 2025 年初,事情变了:
看起来差别不大。但这个差别是本质性的。
模型不再是在做路由——它在导航。它在多个步骤中保持一个目标,解读中间结果,决定下一步做什么,并且知道什么时候该停。每一次观察都会重塑下一个动作。整个轨迹不是预设的,而是从模型的计划和外部世界的反馈之间涌现出来的。
这就是把工具调用变成 Agent 的那个分水岭。关键不是"能调工具"——GPT-4 在 2023 年就能做到。关键是能够在一个连贯的方向上持续调用工具,而不丢失主线。
技术上的原因并不神秘:更好的指令遵循、更长且可靠的上下文窗口、奖励多步任务完成(而非单轮回答质量)的 RLHF。但结果是一次相变——模型从完成函数,变成了完成任务。
打个比方:模型学会了走路。以前它只能迈一步,现在它能连续迈很多步,最终走到一个有用的地方。
第二个变化:从消息流到工作空间(2026)
第二个变化更难描述,而且仍在发生中。但它至少和第一个变化同等重要。
从聊天式大模型诞生以来,上下文一直是以消息流的方式组织的:
这是叙事性上下文。它有开头、有发展、有一个持续推进的结尾。它是按时间排列的,是因果性的——每条消息都在回应前一条。要理解当前对话的状态,你本质上需要从头回放一遍。就像读小说,你没法跳到第 200 页就知道发生了什么。
对于单次会话的聊天,这没问题。对于上面描述的 Agent 工具调用模式也没问题——一个轨迹本质上仍然是线性的、顺序的。
但当你想要一个持续存在的 AI 时,这个模式就崩了。
想想一个持久化的 Agent 在任意时刻需要知道什么:
- 用户是谁(偏好、历史、沟通风格)
- 当前任务是什么(以及它和之前任务的关系)
- 之前尝试过什么(长期记忆)
- 有哪些工具和资源可用
- 当前有哪些相关的文件、文档或数据
- Agent 自身的角色和运行指令是什么
你可以把这些全部编码成一段很长的消息历史。很多人也确实这么做。这就是"超级 Prompt"方案——把所有东西塞进一个线性上下文,然后祈祷模型能找到它需要的东西。
但这就像把数据库存成一个纯文本文件。技术上可行,但扩展不了。更重要的是,它逼着模型去阅读,而模型其实应该能直接看到。
2026 年正在发生的事情是:上下文正在变成一个工作空间——一个结构化的、可寻址的、非线性的空间,不同类型的信息在其中共存,不需要用叙事性的顺序来串联。
模型不再回放一个故事。它扫视一个平面。它知道东西在哪里,什么跟当前时刻相关,什么可以忽略。信息进入工作空间的顺序不决定它的重要性——它与当前任务的关系才决定。
这就是从叙事记忆到工作记忆的转变。
在认知科学中,叙事记忆是情节性的——它把经历存储为按时间排列的故事。工作记忆是主动的、空间化的——它持有当前此刻最相关的内容,按效用组织,而非按时间。
当模型主要在对话数据和消息流结构上训练时,它们发展出了强大的叙事推理能力。它们擅长跟随一条线索、在多轮中保持连贯、基于上文构建下文。
新一代的模型——在结构化上下文、检索增强工作流、多源 Prompt、持久记忆系统上训练的模型——正在发展出不同的能力。它们在学习操作一个工作空间。把上下文不当作一个需要跟随的故事,而当作一张可以工作的桌面。
为什么这两个变化会产生复合效应
每个变化单独来看都很重要。合在一起,它们创造了质变。
连续工具使用让我们有了能完成任务的 Agent。但这些 Agent 仍然生死于单次会话之中。对话结束,Agent 就消失了。新对话开始,一切从零开始。
工作空间上下文让 Agent 能够持续存在。一个拥有工作空间的 Agent 不需要一段持续的对话来维持存在——它需要的是一张摆着自己东西的桌子。合上电脑,明天打开,所有东西还在。Agent 从上次停下的地方继续,不是通过重新阅读一份对话记录,而是通过看看当前桌面上的状态。
更有意思的地方在于:工作空间是可以被共享的。多个 Agent——或者同一个 Agent 的多个角色——可以在同一个工作空间上用不同的指令工作。规划 Agent 写下任务拆解;执行 Agent 直接拿走。研究 Agent 收集信息;写作 Agent 使用信息。它们不需要通过消息"互相对话"。它们在同一个平面上工作。
这也是"人格"这个概念发生变化的地方。在消息流时代,Agent 只有一个人格:它的系统提示词。后续所有内容都是这个人格在说话。在工作空间时代,人格不再是一个固定身份——它是桌面上摆了什么的函数。打开工程工作空间,Agent 像工程师一样思考。打开写作工作空间,Agent 像作家一样思考。同一个模型,不同的上下文,不同的行为。
不是因为有人"切换了它的人格",而是因为工作空间塑造了它关注什么。
对构建者的意义
如果你今天在构建 AI 应用,这两个变化的实际意义是:
停止用消息来思考。 你的上下文不是聊天记录,它是工作空间。像设计工作空间一样设计它——有命名的区域、结构化的数据、清晰的空间布局。模型对这种结构的利用效率,远好于一段 50,000 token 的叙事性文本。
投资上下文架构。 "Context Engineering"这个词的出现不是没有原因的。如何组装、结构化和管理模型上下文窗口中的内容,现在是一个一等公民级别的工程问题——甚至可以说,它就是 AI 应用开发最核心的工程问题。
为持久化而设计。 如果你的 Agent 只能在单次会话中运行,你就浪费了 2026 年最大的能力红利。给你的 Agent 一个跨会话存活的工作空间。让它醒来就能看到自己的桌面。
用轨迹思维取代调用思维。 设计工具集成时,不要针对单次调用优化准确率。针对多步骤的可靠性优化。模型会以你没预想到的顺序调用你的工具。确保每个工具返回足够的信息,让模型能决定下一步做什么。
行业话语会继续制造新术语。等你读完这篇文章,可能又多出三个框架和十几个新缩写。但底层的能力变化就这两个:
2025 年,模型学会了连续迈步。2026 年,模型学会了看到整张桌面。
其他一切,都是这两件事的推论。