如何为长上下文代理设计提示词缓存:一个真实的 Atypica.AI 实验
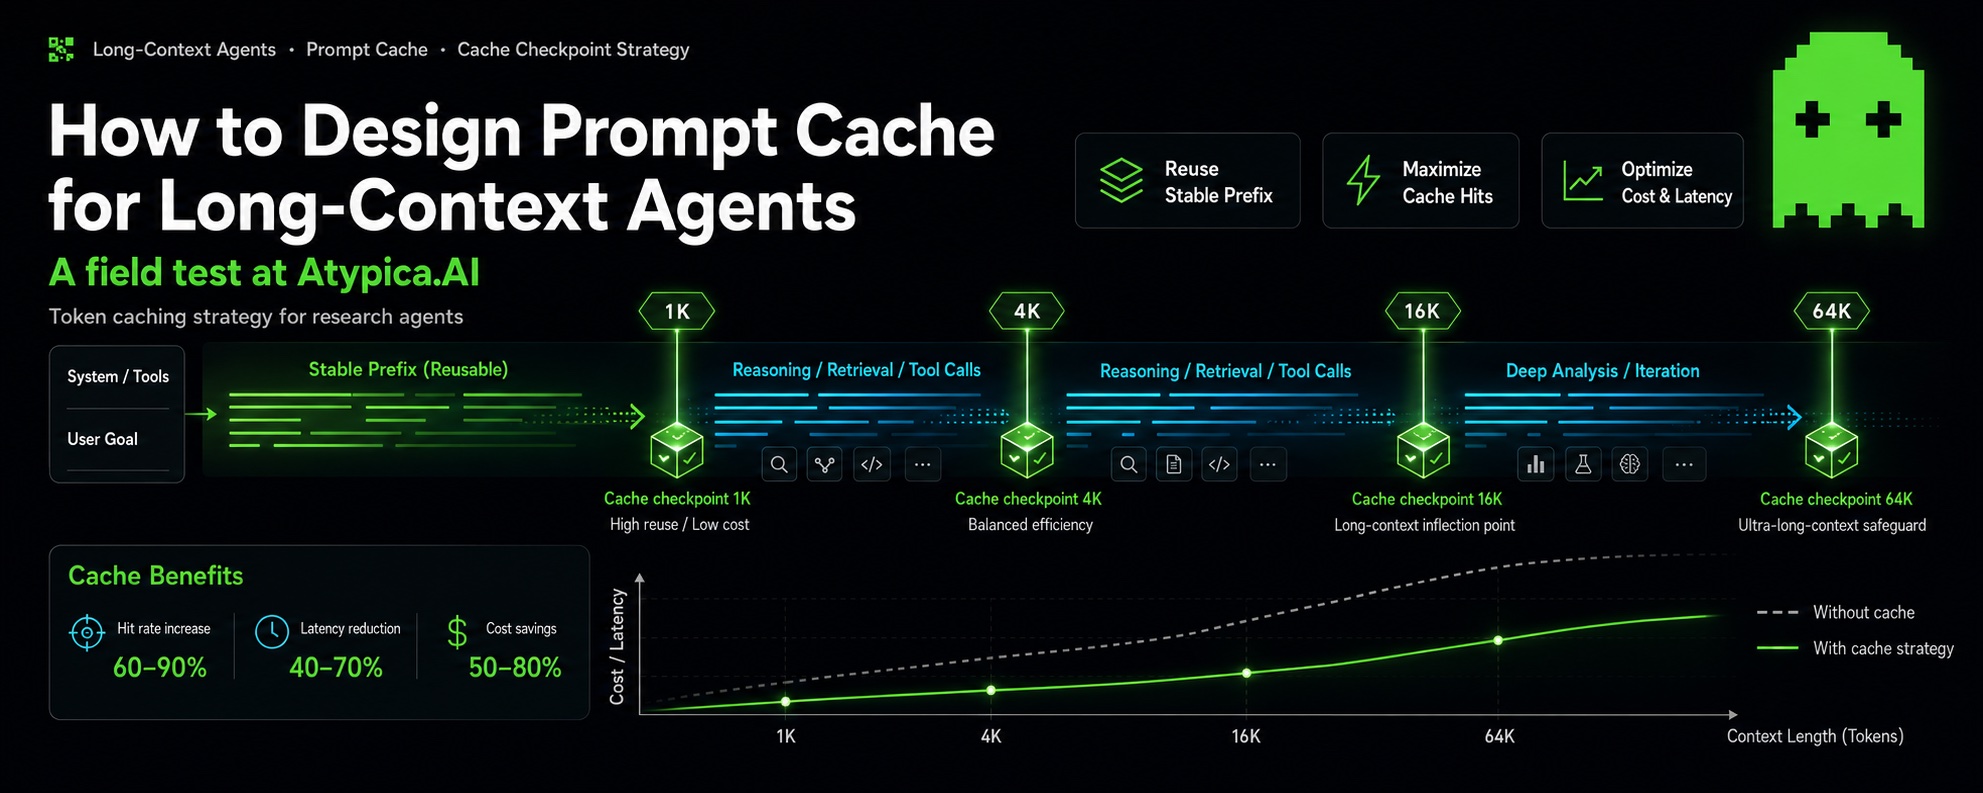
为什么要缓存?
如果一个 AI Agent 只回答一两轮问题,Token 成本通常还比较直观:用户输入多少、模型输出多少,大致就能解释账单。但研究型 Agent 不一样。
在 的商业研究智能体场景里,一个任务会持续累积用户需求、研究计划、工具搜索结果、访谈记录、子 Agent 结论和阶段性报告。越到后面,模型每次调用越需要带上前面已经形成的长上下文。优化之前我们的一个报告通常会消耗约 600,000 Token。
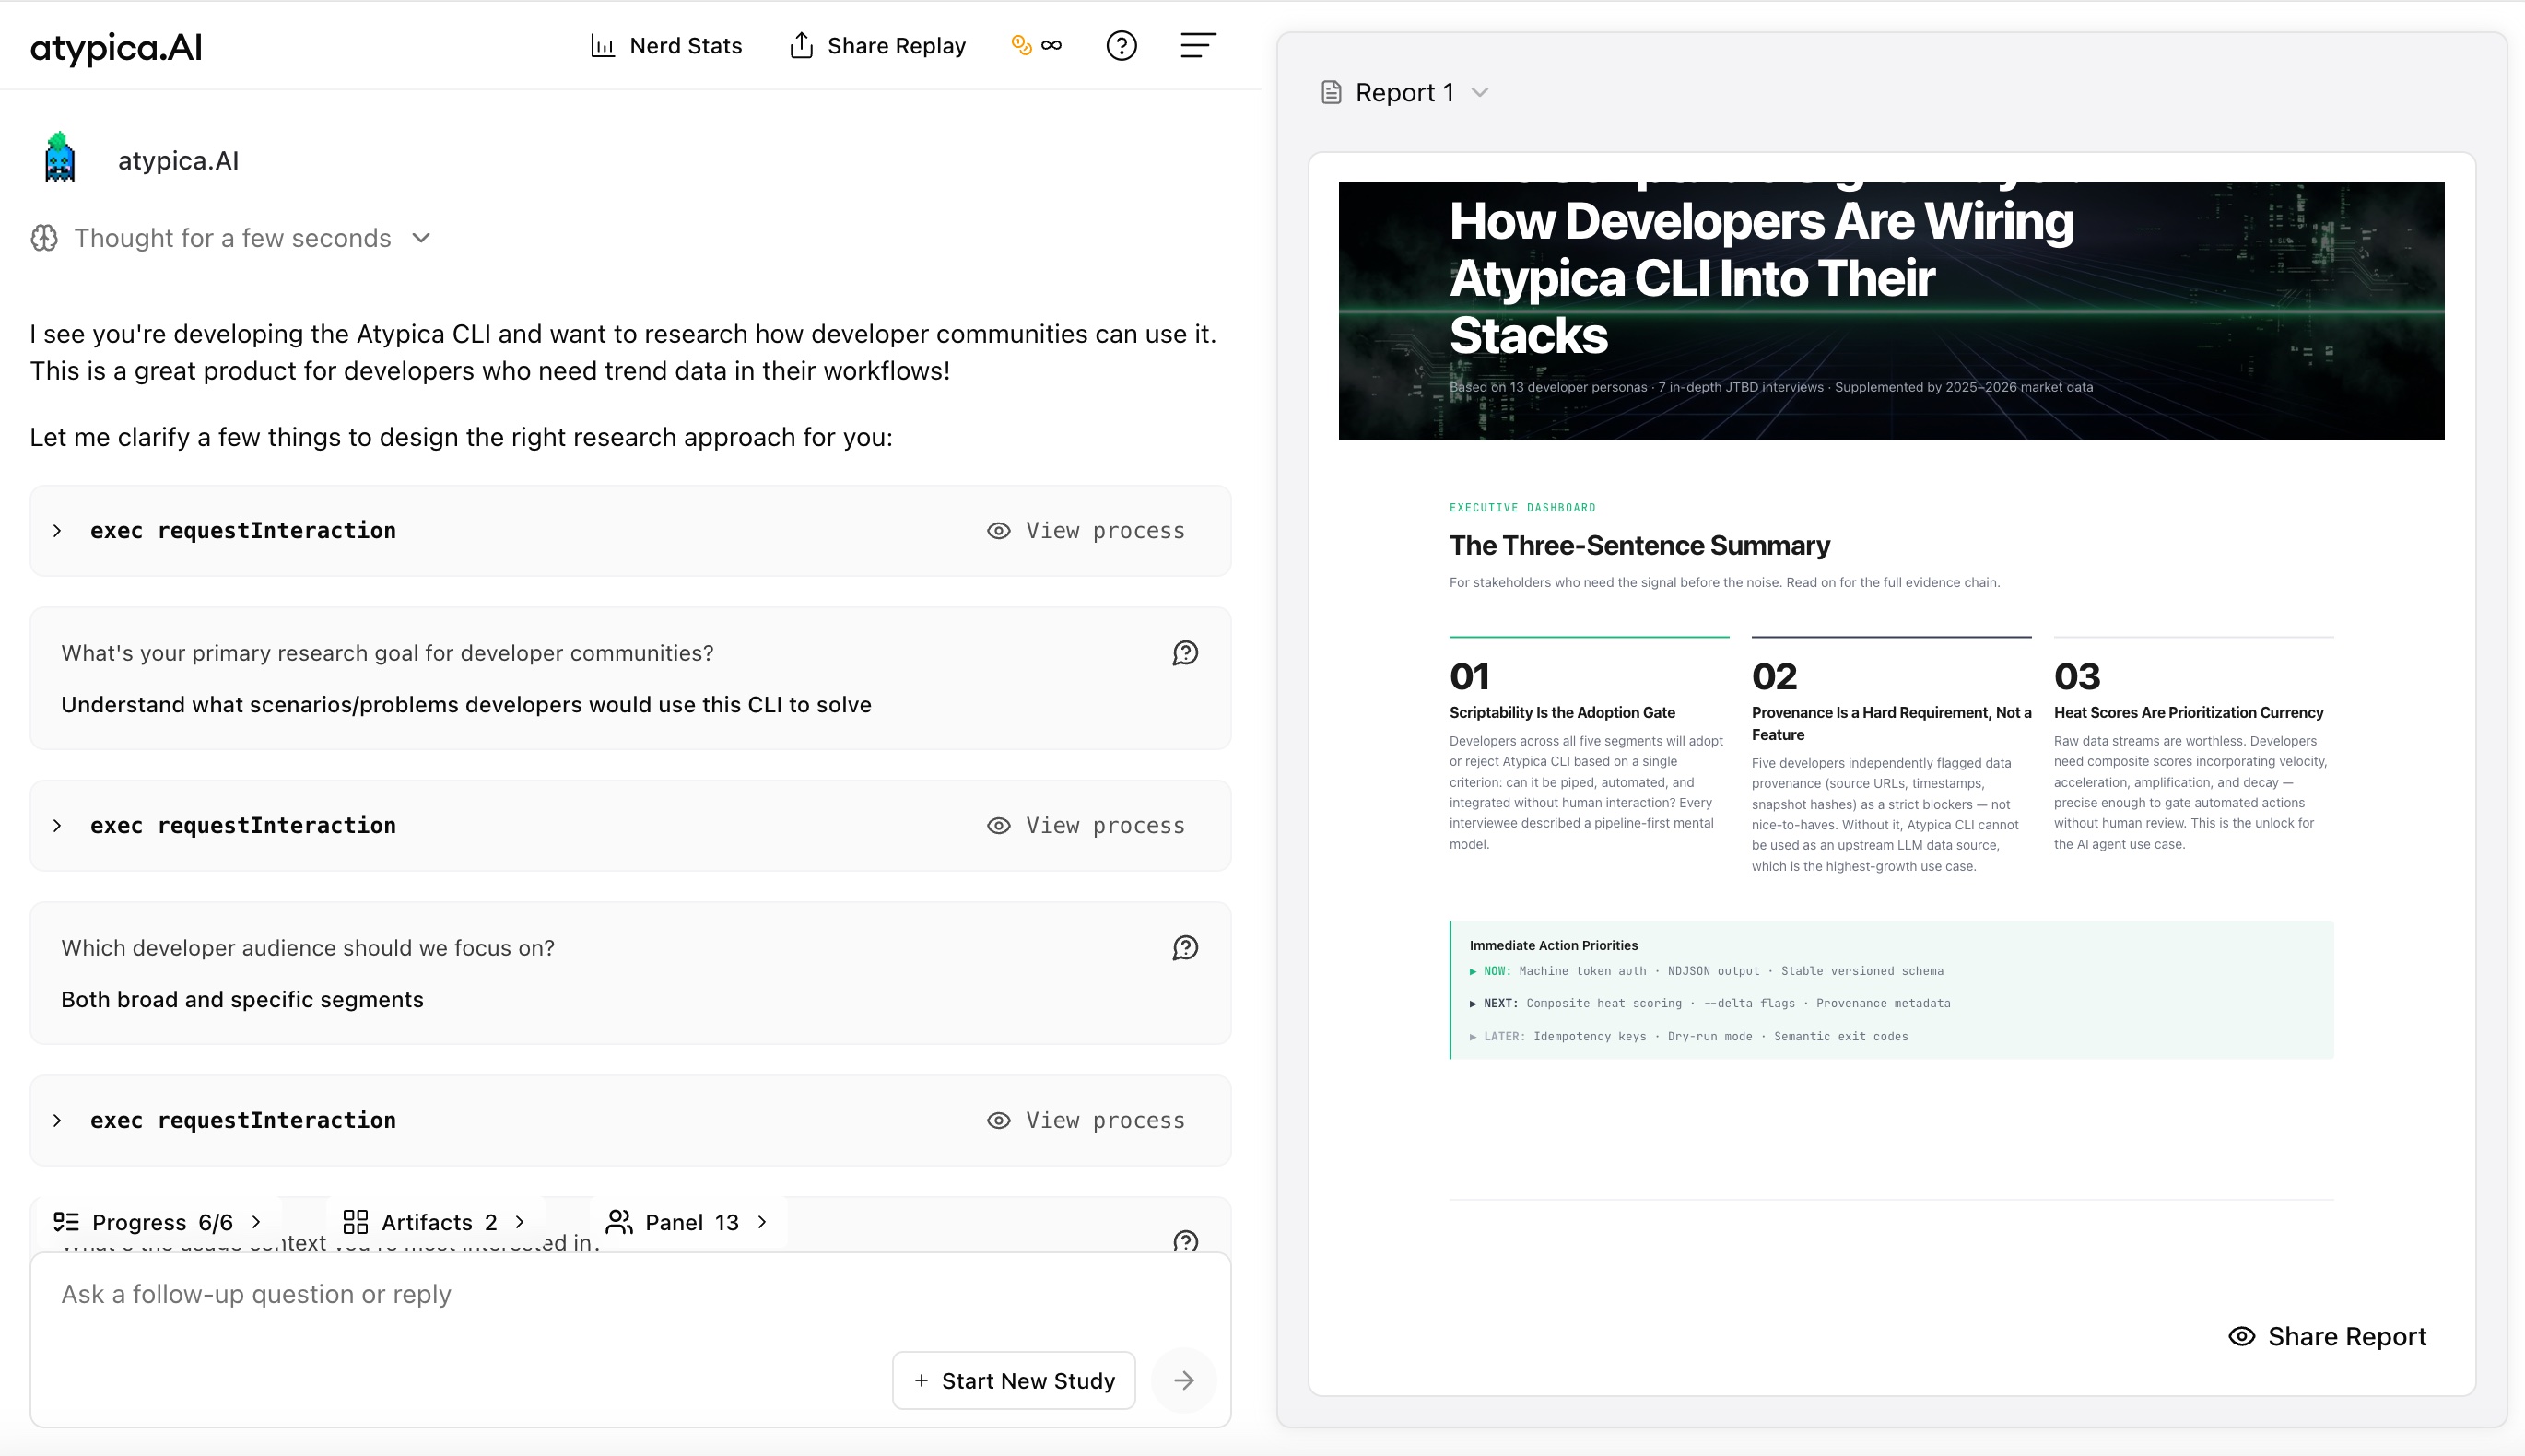
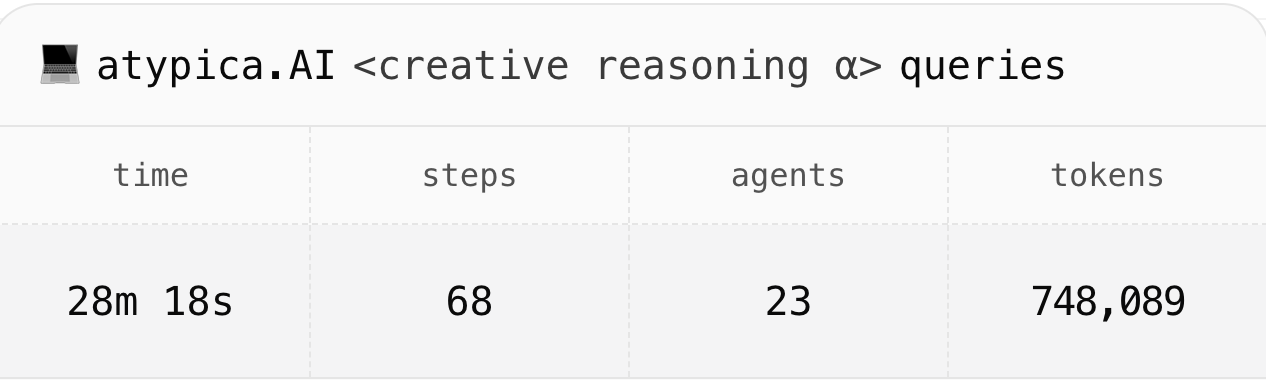
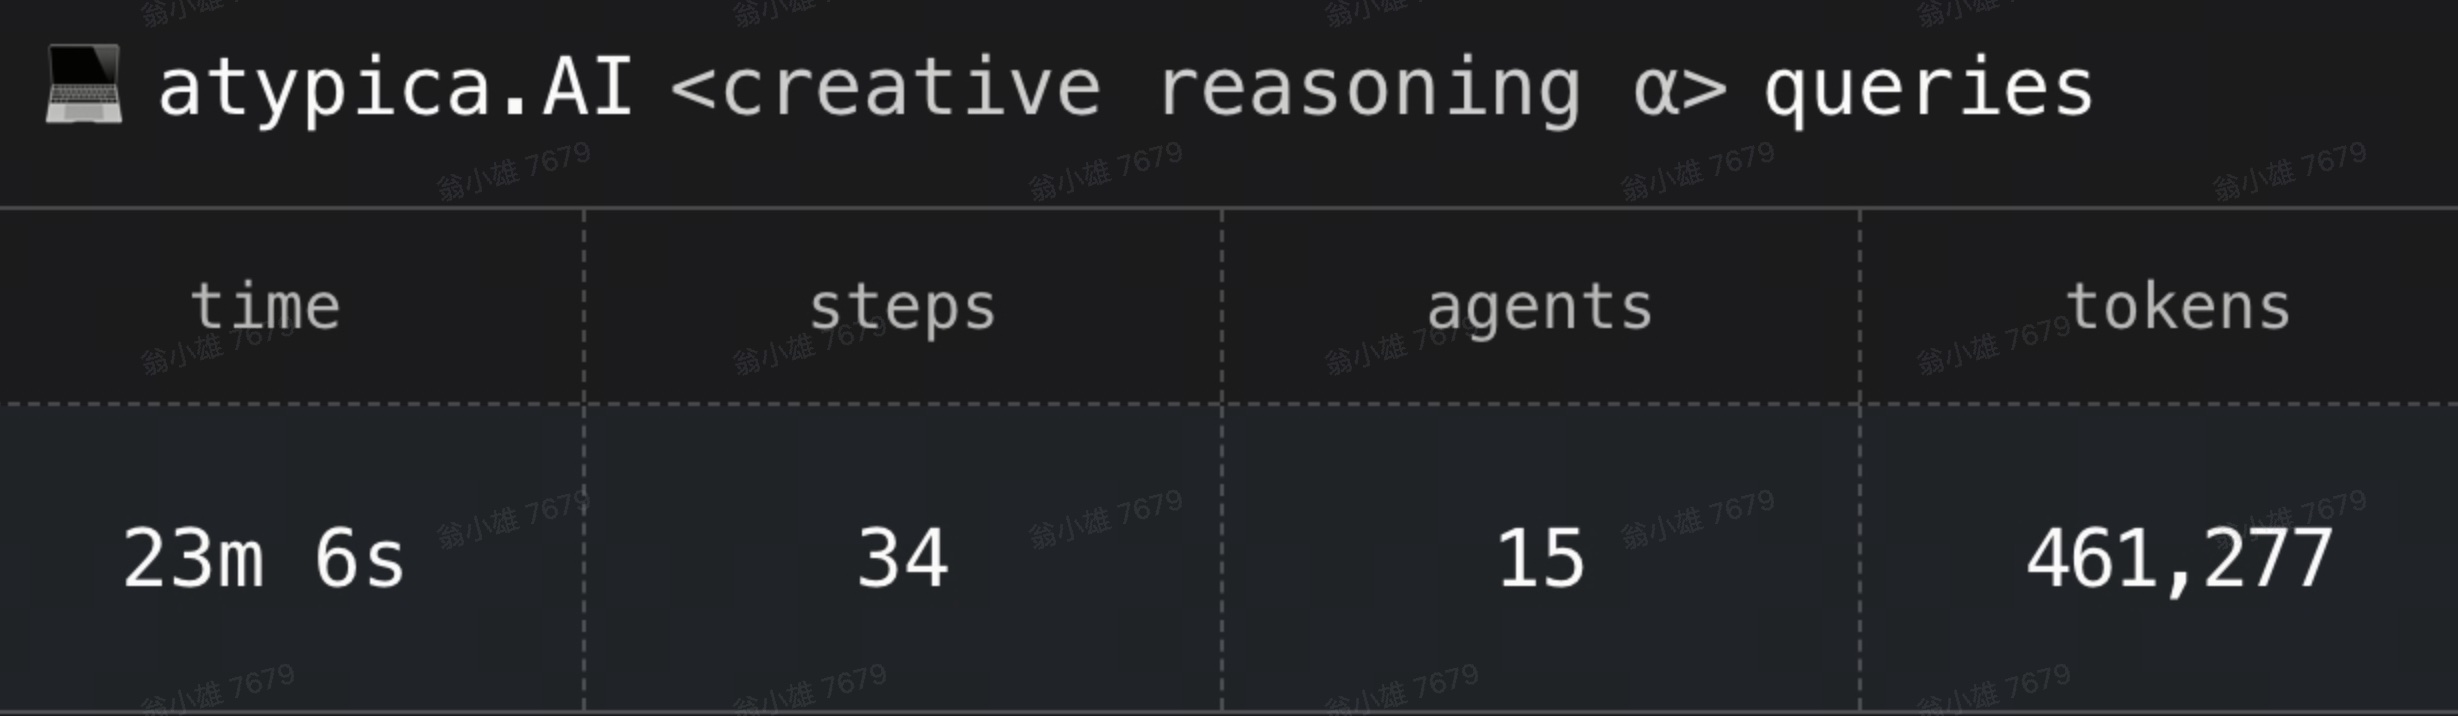
成本真正失控的地方,不是"这一次又生成了多少 token",而是:
同一段已经稳定下来的长前缀,被一次又一次重新送进模型。
Claude Prompt Cache 解决的正是这个问题:把稳定、足够长、后续还会重复出现的 prompt 前缀缓存起来。后续请求命中同一段前缀时,就不必按完整输入重新计费。
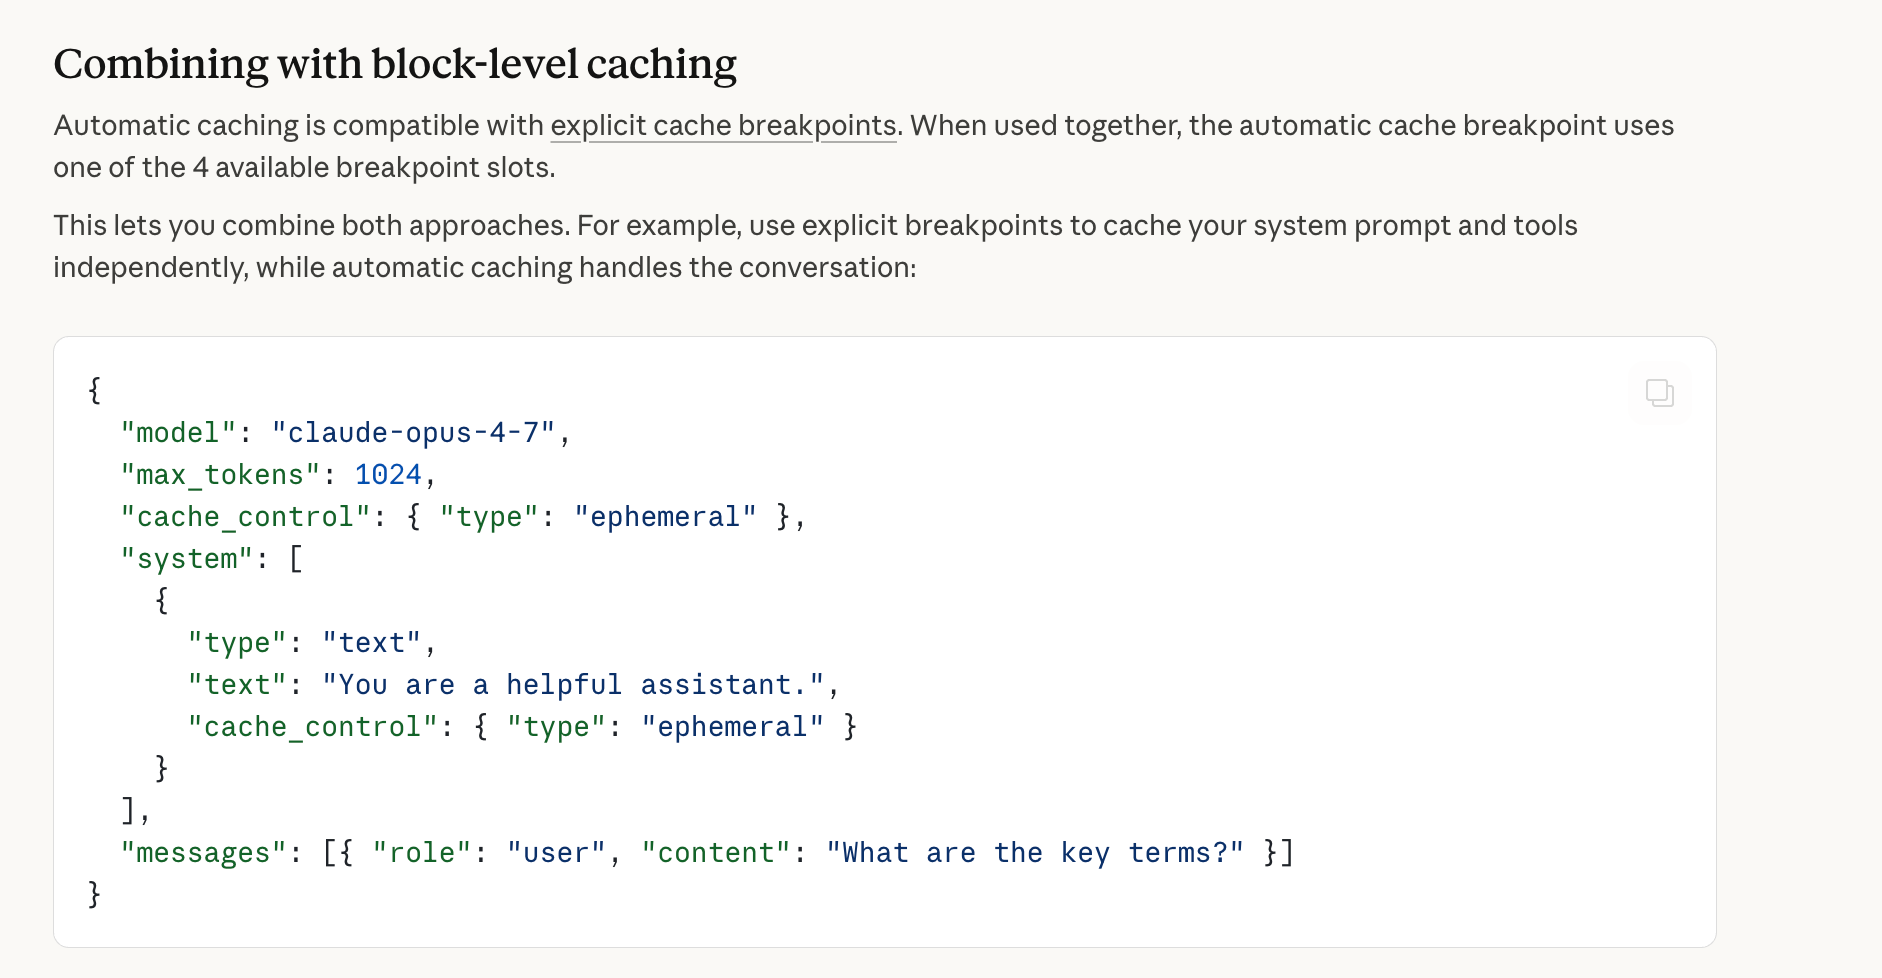
更容易被忽略的是:Anthropic/Claude 的 Prompt Cache 不"自动把历史对话缓存起来"。工程上必须手动在请求消息里放 cache control。放早了,缓存很短,读不到价值;放多了,写缓存本身也会增加成本。对 Claude 请求来说,代码需要在消息上写入 provider options,比如 anthropic.cacheControl、Bedrock 的 cachePoint,没有这个动作,就没有可控的 checkpoint。详见
Checkpoint 跟着 token 长度走,不跟着消息数量走。 一条工具输出可能比十几条聊天消息还长,消息数量不是可靠代理。我们建议只在稳定的消息边界上放 checkpoint。线上请求不能在任意 token 位置切开,只能在可复现的 system、user、assistant 等消息边界挂 cache option。
我们的结论是:不要按"第几条消息"放 checkpoint,要按"累计输入 token 长度"放 checkpoint。策略必须先用历史 session 离线模拟,再用线上 cache metadata 验证。用 DB 里真实 ChatMessage 和 ChatStatistics 做离线模拟,再用 provider metadata 做线上验证。没有 cache read/write 的真实统计,缓存优化很容易停留在"理论上会省"的阶段。毕竟,离线验证能比真实的动态 run 多次节约 token,方便我们来做实验得出一个合适的结论。
研究过程:20 个生产 Session 的静态离线分析
缓存策略不能靠"看起来合理"上线。我们需要回答一个更具体的问题:
如果把这套 checkpoint 策略应用到真实 Study 历史任务里,它到底能不能读到后续复用的长前缀?
为此,我们做了一个离线模拟器。这个过程比最终阈值本身更重要,因为它让缓存策略从"经验判断"变成了"可以复现的成本实验"。
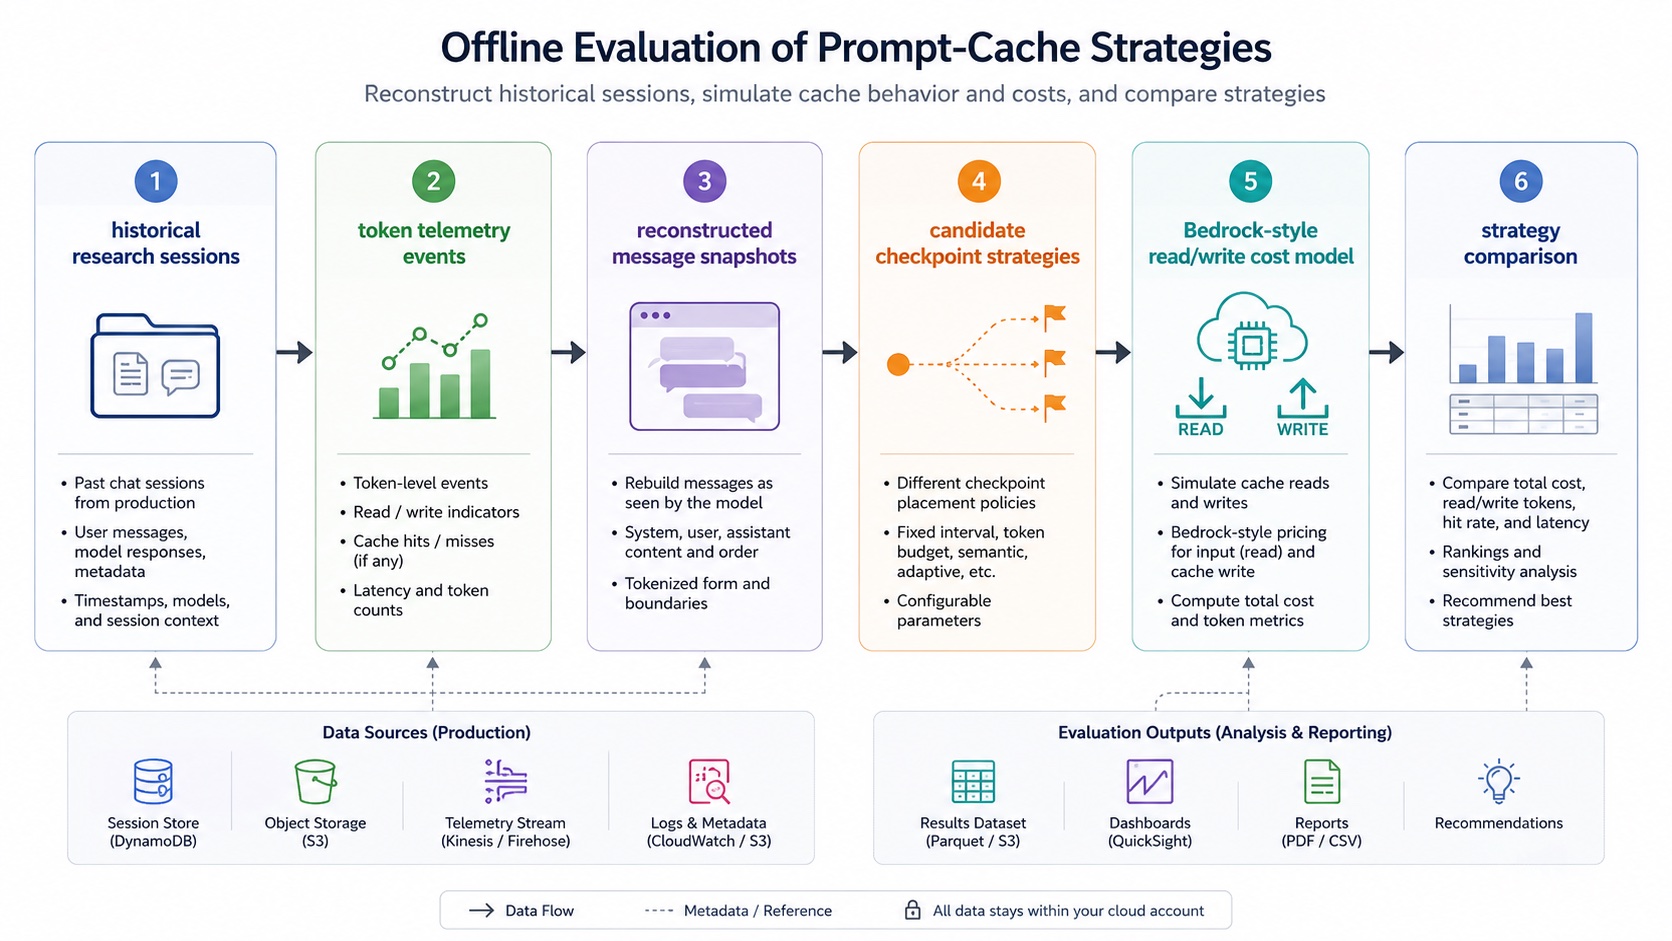
模拟器的关键输入不是 API 返回的摘要,而是数据库里的两类真实记录:
ChatMessage:还原每次模型调用前,Agent 当时能看到哪些历史消息;ChatStatistics:提供真实 token 统计事件,以及这些事件发生的时间。
整体流程是:
- 从生产环境数据里选取 20 个高 token 消耗、比较有代表性的
UserChat.kind = 'study'任务; - 把每一条
ChatStatistics(tokens)视为一次真实 token 事件; - 根据事件时间,从
ChatMessage重建当时的 prompt 前缀; - 在这个前缀上模拟不同 checkpoint 策略;
- 用 Bedrock-style cache read/write 成本模型估算 billed input;
- 比较不同策略的 cache read rate 和 estimated savings。
我们测试的策略包括:
这里有一个很容易踩的坑:不能把 token rows 和 message rows 直接 join 后求和。那会把 token 统计放大。正确做法是分别聚合 token 事件和消息,再在模拟层按时间对齐。
我们还做了 conservative run:排除明显不是聊天历史复用场景的统计事件,例如 web search、report cover image、generateReport、image generation;并且丢掉刚生成的 assistant 输出,近似还原"发给模型前"的输入快照。这样绝对收益会下降,但更接近真实请求前缀。
缓存成本模型:cache write 不是免费的
Prompt Cache 的收益来自 read,但成本来自 write。如果一个 checkpoint 写入后,后面几乎没有请求读取它,那这次 write 就是额外成本。所以我们用近似 Bedrock Claude cache 计费形态的模型来比较策略:
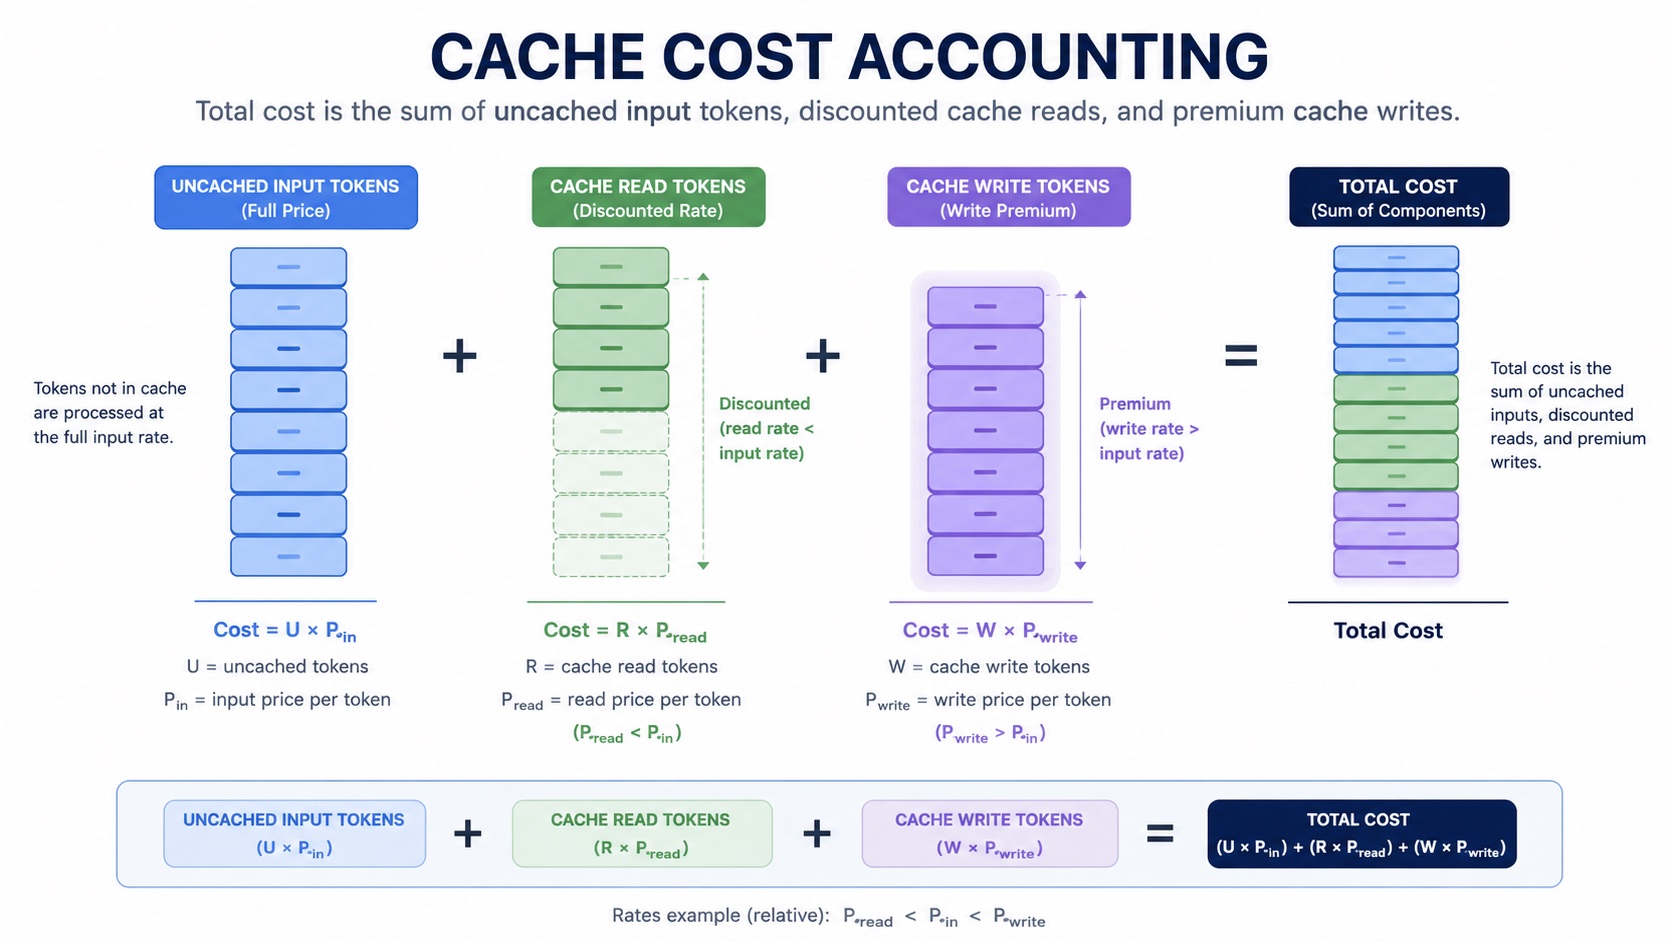
这个模型故意同时做两件事:
- 奖励长前缀复用:cache read 越多,估算成本越低;
- 惩罚无效写入:频繁写 cache 但后续读不到,会被 write premium 拉高成本。
也就是说,我们比较的不是"哪个策略放的 checkpoint 多",而是"哪个策略能把 checkpoint 变成后续真实可读的缓存"。
我们如何知道缓存的 checkpoint 要放在哪里?
经过多次实验,最终生产实现采用的是:
const thresholds = [1024, 4096, 16384, 65536];
也就是 1K / 4K / 16K / 64K。它不是拍脑袋选出来的,而是从一轮研究过程里收敛出来的:
- 第一版按 message index 放 checkpoint;
- 发现 index 策略在长上下文 Study 里效率很低;
- 拉生产环境里 20 个高 token 消耗的代表性 session;
- 用真实
ChatMessage重建每次调用前的 prompt 前缀; - 用
ChatStatistics的 token 事件做时间锚点; - 跑多组 checkpoint 策略,比较最终估算 token 消耗;
- 再用 Anthropic 路径做真实 cache write/read 验证。
离线结果里,4K / 12K / 24K / 48K 在 base run 里分数最高。但保守模拟和生产可解释性更支持 1K / 4K / 16K / 64K 作为默认策略。这个区别很重要:我们不是追求某个离线表格里的单次最高分,而是在收益、稳定性和工程可观测性之间取一个更稳的默认值。
第一版:按 message index 缓存
我们一开始采用过最容易想到的策略:message-index heuristic。
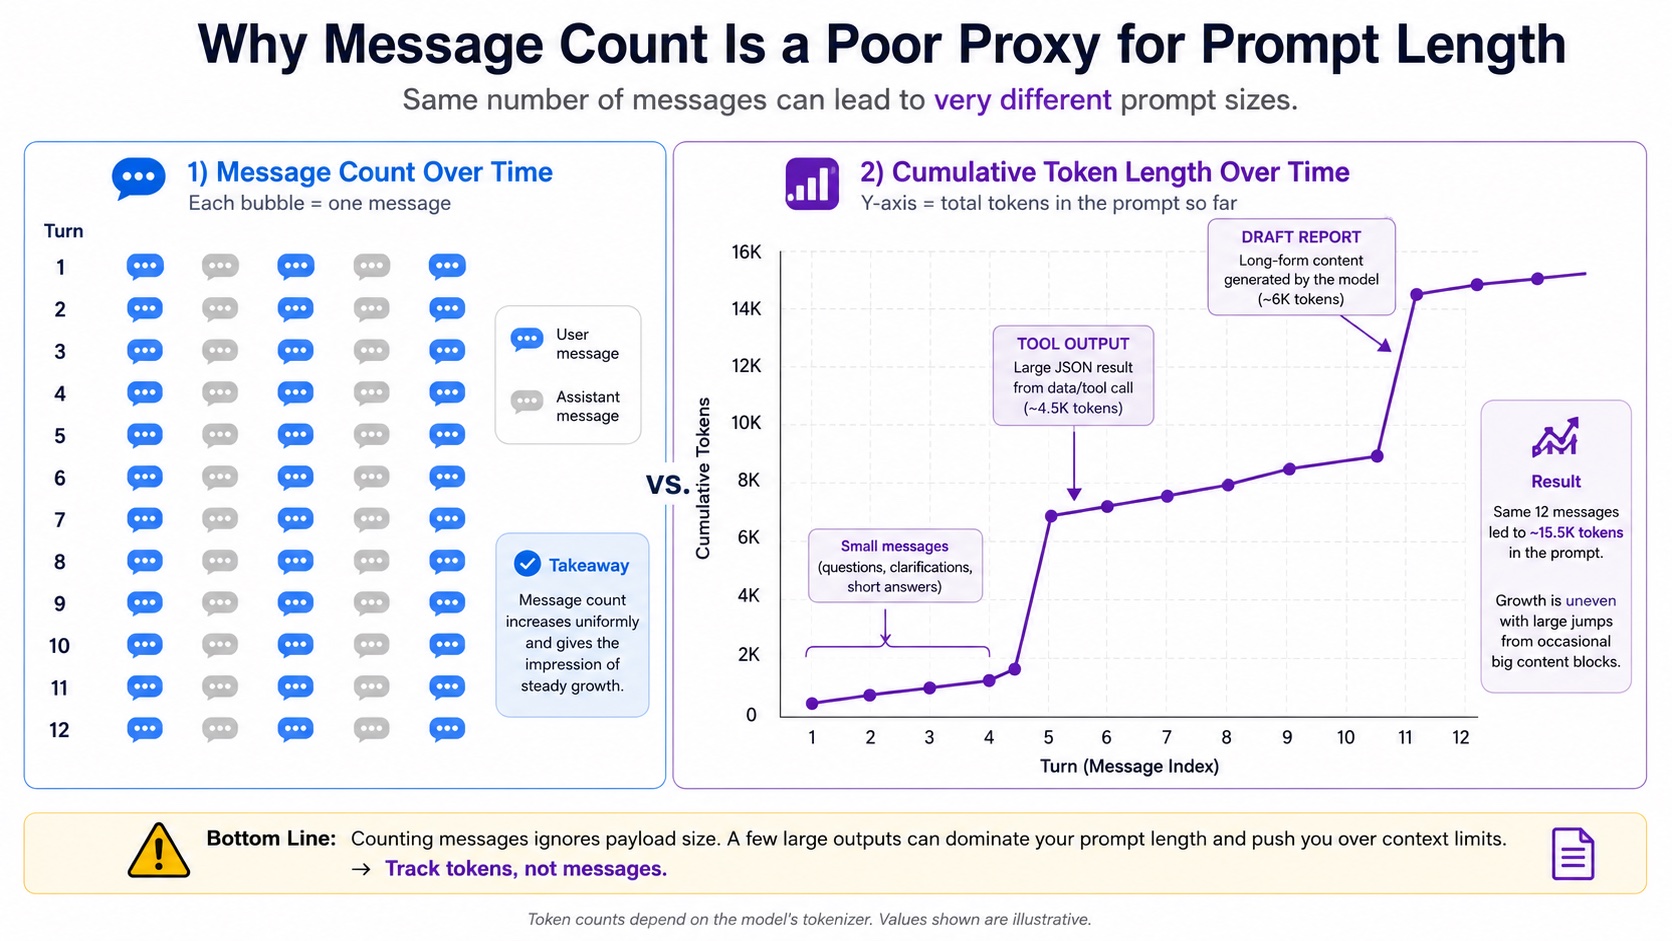
这个策略的问题是,它默认"消息数量"和"上下文长度"大致相关。在研究型 Agent 里,这个假设经常不成立:
- 前 20 条消息可能只是短计划和状态更新,总共不到几千 token;
- 第 21 条消息可能是一次工具返回,直接增加几万 token;
- 第 22 条消息可能是报告草稿,又增加几万 token。
真正跑下来后,我们发现这个假设在 Study 里不成立。如果 checkpoint 放得太早,它缓存到的只是很短的前缀,后续读不到多少价值。如果 checkpoint 放得太晚,它又错过了很多已经稳定复用的中间上下文。如果某条工具消息突然很长,按 index 放点还可能完全错过成本最高的上下文拐点。
因此,我们改用 token-length heuristic:
不关心现在是第几条消息,只关心累计输入 token 有没有跨过关键阈值。
第二版:按累计 token 阈值放 checkpoint
策略本身并不复杂。
- 顺序遍历即将发送给模型的消息;
- 估算每条消息序列化后的 token 长度;
- 累加当前 prompt 的输入 token;
- 当累计 token 跨过某个阈值时,在附近可缓存的消息边界放 checkpoint;
- 最多保留 4 个 checkpoint,符合 Claude Prompt Cache 的约束;
- 只选择稳定、线上可复现的消息边界。
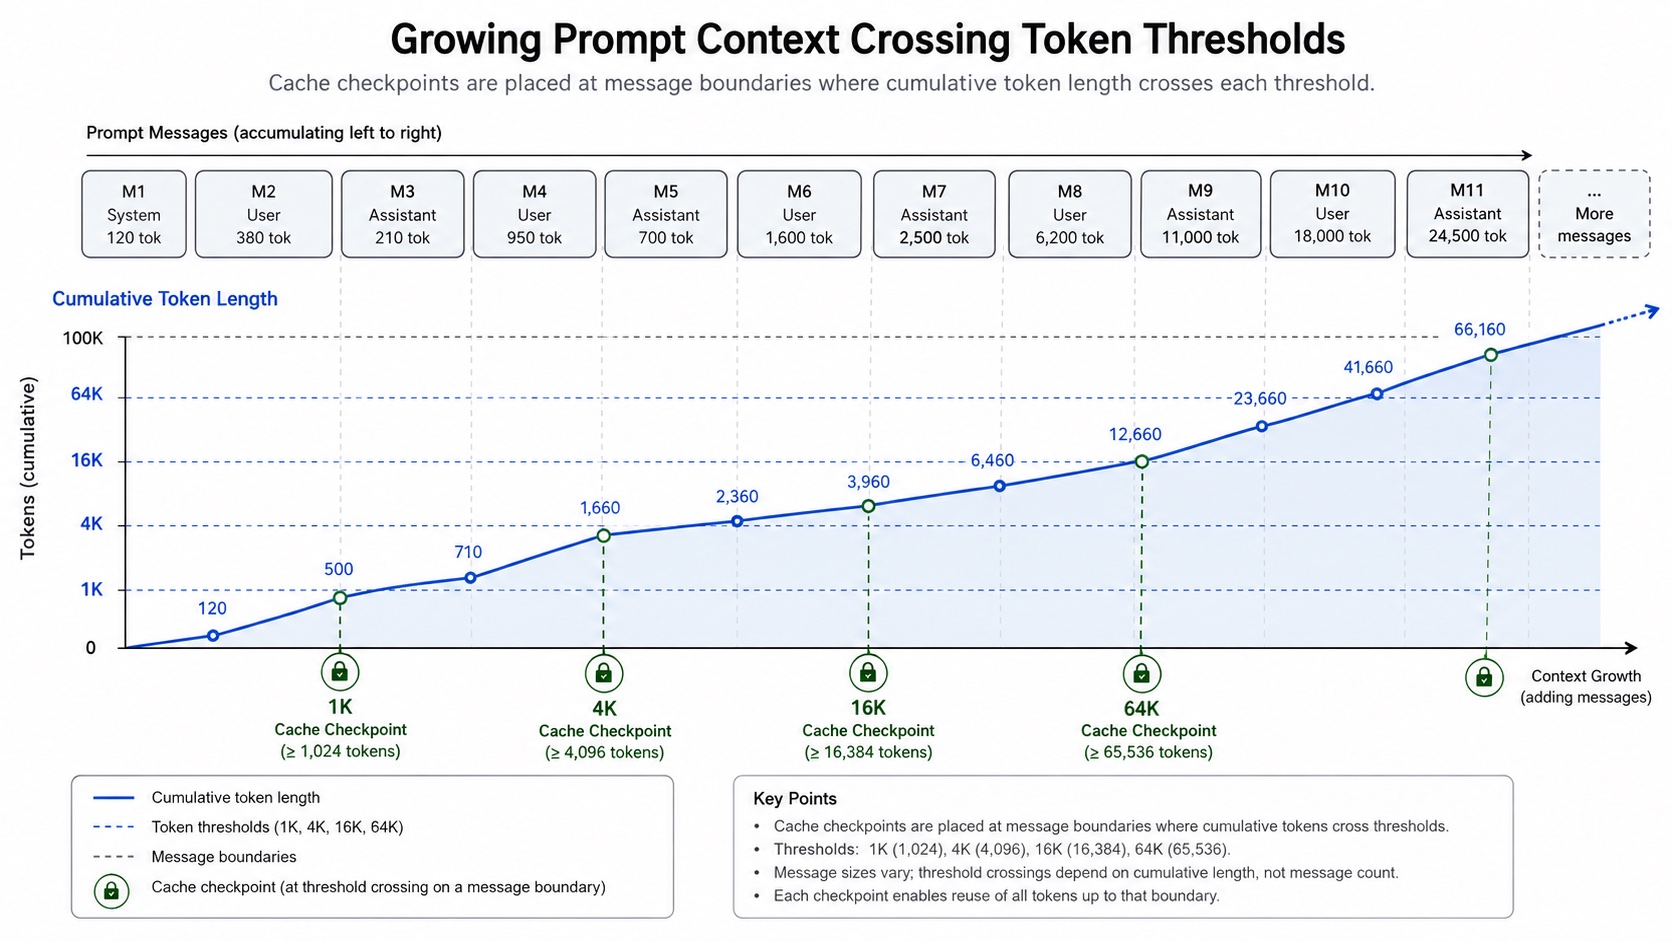
当前生产实现使用的是 1K / 4K / 16K / 64K:
const thresholds = [1024, 4096, 16384, 65536];
这组阈值的含义很直接:
- 1K:让较短的研究任务也有机会尽早复用稳定前缀;
- 4K / 16K:覆盖多数 Study 任务进入密集工具结果和阶段总结后的区间;
- 64K:给超长研究任务保留后段 checkpoint,避免所有缓存点挤在早期;
- 最多 4 个点:和 provider 限制对齐,工程行为更可控。
这个策略不试图理解每个工具输出的语义,也不需要预测最终上下文长度。它只抓住一件事:当输入前缀已经长到值得复用,就在稳定边界上留下缓存点。
模拟结果:index 策略基本不够用
第一轮 base run 使用 20 个高 token Study session:
- 实际内部 token 账本总量:11.3M;
- token 统计事件:1,779;
- message-derived simulated calls:1,779;
- message-derived estimated input tokens:53.3M。
这一轮里,4K / 12K / 24K / 48K 是最强静态候选:
这个结果说明:第一版 index 策略不是小幅落后,而是基本没有抓住 Study 里真正长、真正会复用的前缀。但 base run 仍然偏乐观,因为部分 token stats 发生时,assistant 输出可能已经写入数据库。于是我们又跑了 conservative run:排除非聊天历史复用事件,并丢掉当前 assistant 输出。
这就是最终选择 1K / 4K / 16K / 64K 的原因:base run 里 4K / 12K / 24K / 48K 最高,但 conservative run 里 1K / 4K / 16K / 64K 更稳,而且它更容易解释和监控。生产默认策略应该优先选择稳健可观测,而不是只追求某一次离线样本的最高分。
最重要的不是把 72.9% 或 86.9% 当成线上收益承诺,而是理解策略差异:
message-index checkpoint 往往缓存不到真正长、真正会复用的前缀;token-threshold checkpoint 更容易踩中研究型 Agent 的成本集中区。
这和 Study 场景的上下文结构是一致的。成本不是平均分布在每条消息上,而是集中出现在少数长工具输出、子任务总结和报告草稿之后。
上线前还要验证真实 provider metadata
离线模拟只能说明"这个策略在历史上下文上更合理"。它不能证明真实请求一定命中 cache。上线前还需要验证两件事:
- cache option 是否真的进入 Claude 请求;
- provider 返回的 cache metadata 是否能被内部 token 账本记录下来。
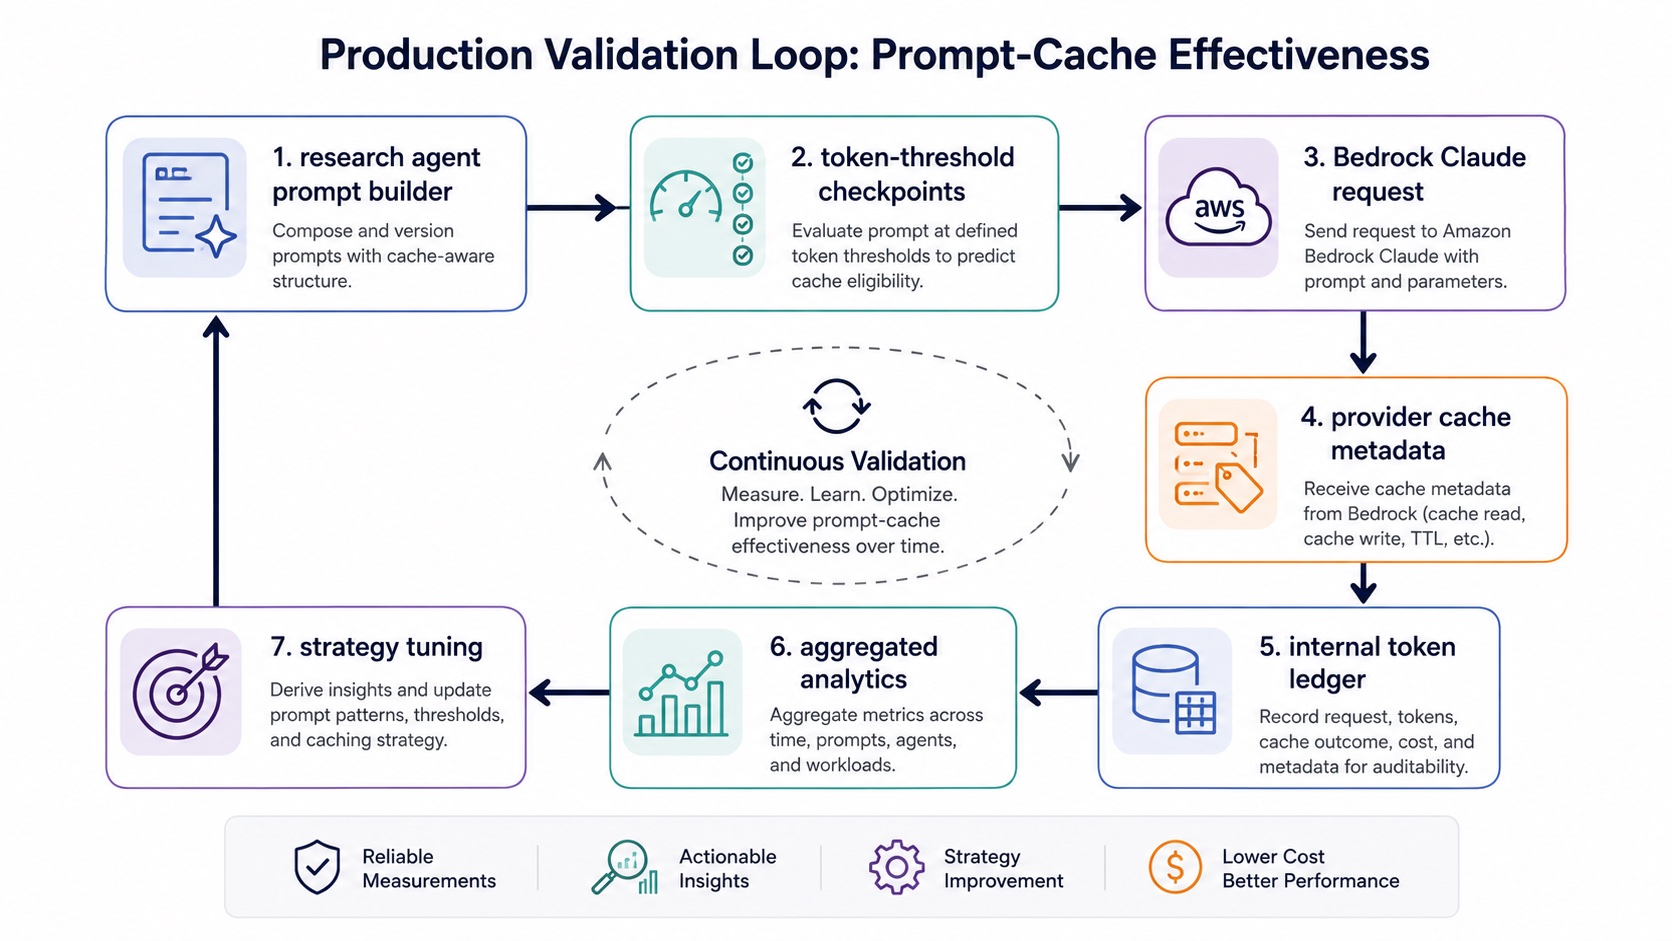
我们最终需要在统计链路里看到这些字段:
cacheReadInputTokens、cacheWriteInputTokens
这一步很关键。因为工程上经常会出现三种看起来相似、实际完全不同的状态:
- 代码选择了 checkpoint;
- 请求里真的带上了 cache option;
- provider 真的返回了 cache read/write。
只有第三个状态进入 ChatStatistics.extra.cache,我们才能说缓存收益进入了可观测账本。
在 PPIO/Anthropic 路径的 smoke test 里,同一段长前缀连续请求时,第一次请求返回:
第二次请求返回:
这说明 cache write 和 cache read 都能从 provider metadata 里拿到。之后我们又在本地 Study 验证路径里看到了 cacheReadInputTokens 和 cacheWriteInputTokens 落入统计表,证明这条链路不只是请求层能 work,也能进入 Atypica.AI 自己的 token 账本。
这次优化留下的工程经验
第一,缓存策略要绕 prefix reuse 设计。 长上下文 Agent 的成本大头,往往是稳定前缀的重复输入,不是单次输出。
第二,Anthropic 缓存需要手动打 checkpoint。 不要把 Prompt Cache 理解成 provider 自动优化。系统必须显式选择边界,并把 cacheControl / cachePoint / cache_control 写进请求。
第三,cache write 是有成本的。 写得越多不一定越省。只有后续真的读到足够长的稳定前缀,write premium 才能被摊薄。
第四,消息数量不是可靠指标。 工具调用、报告草稿、子 Agent 结果都会让上下文突然变长。第几条消息并不能说明前缀是否值得缓存。
第五,固定 token 阈值是一个强默认值。 它足够简单,容易解释,容易监控,也不依赖复杂的工作流语义判断。
第六,离线模拟必须使用真实消息和真实 token 事件。 只看 API 摘要或当前前端统计,容易低估或高估历史调用。
第七,线上验证必须落到 cache read/write 账。 没有 provider metadata,缓存策略很难从"理论优化"变成"可持续优化"。
结语
对研究型 Agent 来说,Prompt Cache 不是一个简单开关,而是一套围绕长上下文增长方式设计的成本策略。
Atypica.AI 这次实验的核心收获可以浓缩成一句话:
手动把 checkpoint 放在累计 token 跨过关键阈值后的稳定消息边界上,再用真实历史数据和线上 cache metadata 验证它。
这套方法不追求一次性找到永远最优的阈值。它更重要的价值是形成一个可迭代闭环:用历史任务选择策略,用真实 provider metadata 验证收益,再用新的线上数据继续校准阈值。
长上下文 Agent 的成本优化,最终拼的不是某个神奇参数,而是能不能把上下文结构、provider 计费模型和内部统计账本连成一条可靠链路。